Распознавание документов нейросетью давно перестало быть просто превращением картинки в текст. Современная модель понимает, где на странице поставщик, где сумма, а где номер партии, даже если документ мятый, сфотографирован под углом и заполнен от руки. Разберём, как это выглядит в реальной работе.
Почему обычный OCR не справлялся
Старые программы умели одно: найти буквы на изображении. Распознавание текста документов они выполняли неплохо на чистом скане, но дальше человеку всё равно приходилось разбираться, какая цифра что означает. У каждого поставщика своя форма, свои колонки, свои сокращения, и шаблон под каждую приходилось настраивать вручную.
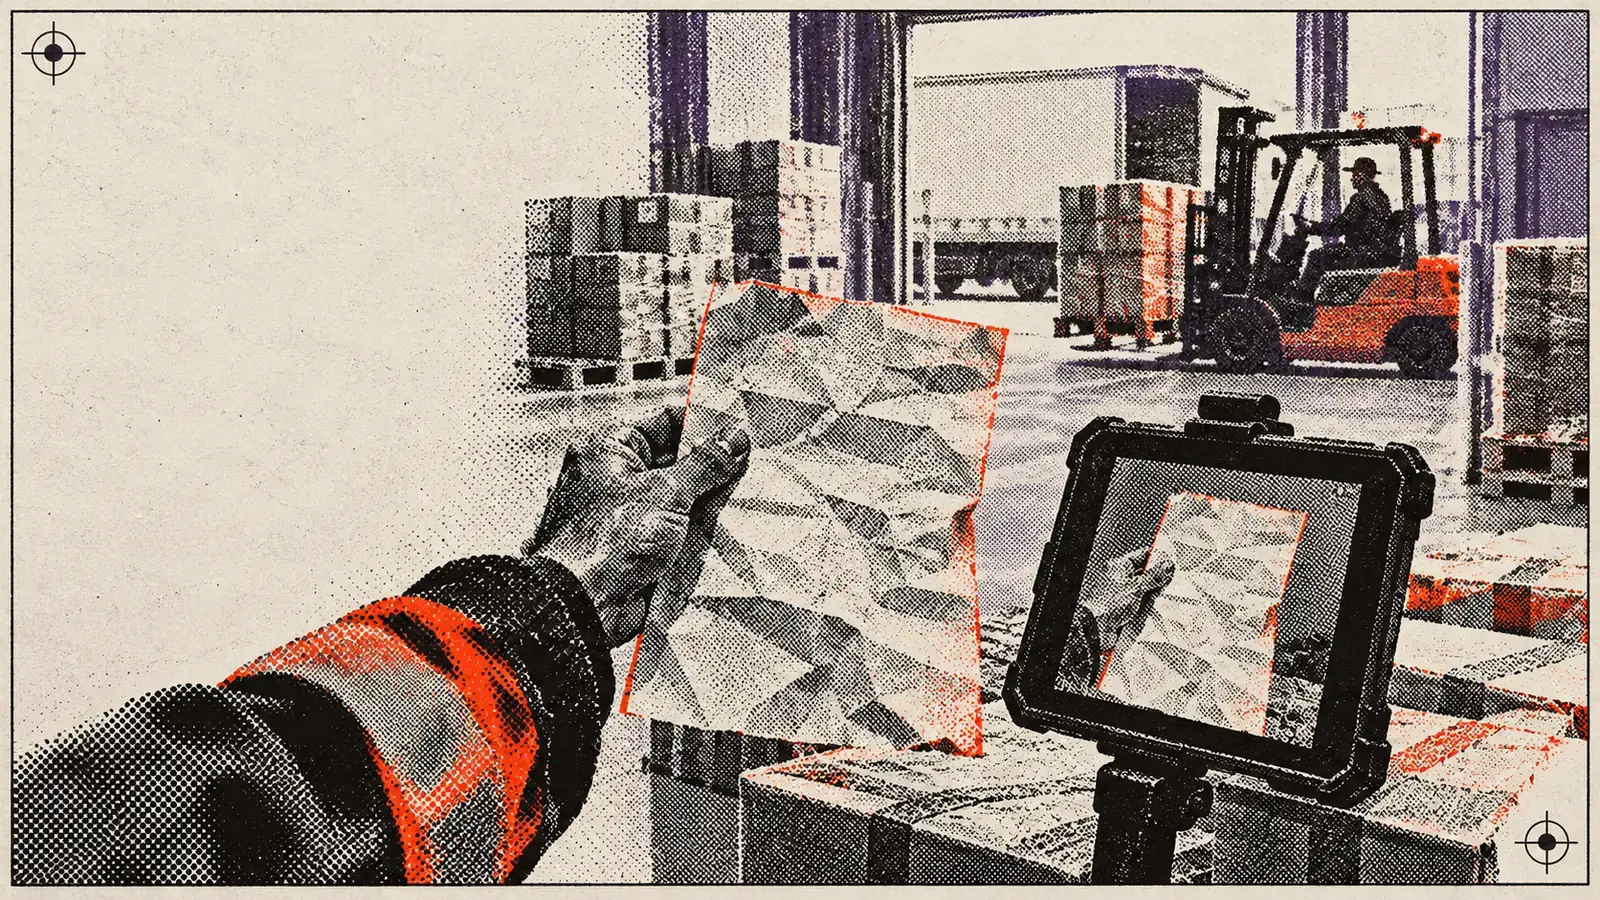
На складе это превращалось в очередь: машина стоит под разгрузкой, кладовщик сверяет накладную с заказом глазами, оператор потом перебивает её в учётную систему. Ошибка в одной позиции означает пересорт, который найдут только на инвентаризации.
Как работает распознавание документов на нейросети
Новый подход состоит из трёх шагов, и шаблоны под каждого поставщика больше не нужны:
- Картинка приводится в порядок. Выравнивается перекос, убираются тени, усиливается контраст.
- Модель читает документ как человек. Она понимает структуру таблицы, находит шапку, строки товаров, итоги, даже если форма видна впервые.
- Данные проверяются по смыслу. Сумма строк сходится с итогом, артикулы есть в справочнике, количество не превышает заказ.
Если модель в чём-то не уверена, поле подсвечивается для проверки человеком. Оператор смотрит не весь документ, а одну-две сомнительные ячейки. Такой сервис распознавания документов можно держать в облаке или на сервере компании, если данные нельзя выносить наружу.
Пример: оптовый склад на 300 поставщиков
Оптовый склад продуктов питания: 45 сотрудников, около 300 поставщиков, 150-200 приёмок в день. Каждая накладная в среднем на 25 строк. Три оператора вручную вбивали приход, тратя на одну накладную 6-8 минут. В пиковые дни приход отставал от физической разгрузки на сутки, а расхождения по количеству находили в среднем в 4% документов, часто уже после оплаты поставщику.
Настроили приём фото накладной прямо с планшета кладовщика, распознавание всех строк, сопоставление товаров с номенклатурой по названию и артикулу и сверку с заказом. Расхождения показываются кладовщику сразу, пока машина ещё у ворот.
Через два месяца обработка одной накладной занимала около минуты, из них большая часть на проверку подсвеченных полей. Отставание прихода исчезло. Расхождения стали ловить при приёмке, а не после, и претензии поставщикам начали выставлять в тот же день. Одного оператора перевели в отдел закупок. Проект окупился примерно за четыре месяца.
Сколько стоит и сколько длится
Внедрение относится к услуге «ИИ-документооборот»: от 250 000 ₽ и от 21 дня. На итог влияют:
| Параметр | Что меняет |
|---|---|
| Качество исходников | Фото с телефона требуют больше предобработки, чем сканы |
| Сопоставление с номенклатурой | Разные названия у поставщиков требуют обучения на ваших данных |
| Где работает модель | Облако или сервер компании |
| Интеграция | С какой учётной системой обмениваемся данными |
С чего начать
- Соберите 100 реальных документов от разных поставщиков, включая самые неудобные.
- Замерьте, сколько минут сейчас уходит на один документ.
- Определите, какие поля критичны, а какие можно пропустить.
- Оставьте заявку: прогоним ваши документы через модель и покажем точность до начала проекта.
Нейросеть не ошибается от усталости в конце смены, но и не заменяет проверку там, где она неуверена. Правильно настроенная система берёт на себя 90% рутины и честно показывает, где нужен человек.